1916 年 4 月 30 日,马尔可夫于彼得堡宣读那篇论文三年之后,克劳德·香农在美国密歇根州北部的小镇佩托斯基呱呱坠地。
小时候,他是爱伦·坡《金甲虫》的忠实读者。小说里的主人公勒格朗靠英文字母出现的频率,解开了一张藏宝图上的密码。
香农后来回忆说,自己从小就爱解密码题。
1945 年 9 月 1 日,离日本在密苏里号上签字投降还有一天。那个爱解密码题的孩子,这时已经在贝尔实验室工作了四年。他发出了一份备忘录,题目叫《密码学的数学理论》,封面上标着"机密"。
正文里夹着几段奇怪的字母,下面是其中三段。
XFOML RXKHRJFFJUJ ZLPWCFWKCYJ FFJEYVKCQSGHYD QPAAMKBZAACIBZLHJQD
ON IE ANTSOUTINYS ARE T INCTORE ST BE S DEAMY ACHIN D ILONASIVE TUCOOWE AT TEASONARE FUSO TIZIN ANDY TOBE SEACE CTISBE
THE HEAD AND IN FRONTAL ATTACK ON AN ENGLISH WRITER THAT THE CHARACTER OF THIS POINT IS THEREFORE ANOTHER METHOD FOR THE LETTERS THAT THE TIME OF WHO EVER TOLD THE PROBLEM FOR AN UNEXPECTED
最上面那段杂乱到无法理解,中间那段里已经冒出了 ARE、BE、AT 几个真实的英语单词,还有 DEAMY 这种字典里查不到、念起来却很像英语的东西。
到了最后一段,单拿出中间那十个词,attack on an English writer that the character of this,"向一位英国作家正面进攻,说这一点的性质",这几乎可以说的上是一句正经话了。
这几段话没有作者。它们是一个字母、一个词地抽出来的,每抽一次,只看英语里什么字母常跟在什么字母后面,什么词常跟在什么词后面。
马尔可夫数字母,是为了证明它们一个牵着一个。二十九岁的香农反过来,照着这些牵连一个接一个地往下写,写出了从来没有人写过的句子。
战争期间,他在贝尔实验室做火炮控制和密码方面的研究。据他后来说,信息论的那些想法,大多是那几年下班以后在家里琢磨出来的,这几段假英语也在其中。
一份讲密码的机密报告,为什么要费这么大的劲去造假英语?三十多年后有人问起,香农笑着说,密码学是他拿来给这些研究正名的,"让我看起来像在干正经事"。
他真正惦记的是另一个问题。我们写下的字母,有多少是自己选的,又有多少,其实是英语早就替我们选好了的?
语言的冗余
爱伦·坡写的那道密码能解开,靠的是统计学特征。英文字母出现的机会并不均等:E 最多,T 其次,Q 后面几乎总跟着 U。凯撒加密法只是把字母换掉了,却换不掉这些频率特征。这些英文自己的规律,就成了破译者手里的线头。
香农把这种规律叫作"冗余"。一段英文,光把元音删掉就能省下四成,而句子照样读得回来,那么这就说明英语至少有四成是多余的。冗余越多,密文里漏出来的线头就越多,要破译一份密码,需要截获的密文也就越少。
要估算英语的冗余,先得有英语的统计,可他手头的现成材料并不多。一本 1939 年出版的密码通俗读物里,印着单个字母、两个字母、三个字母连在一起的频率表。另一本 1923 年的书里,从报纸、小说、演讲、书信和广告里数了十万个英文词,排出了词频。至于四个字母连在一起的频率,据他所知,还没有人完整地数过。
光看这些表格,看不出这些统计在这里有多大分量。香农想了个直观的办法,照着统计去造假的英语,看看造出来的东西有多像英语。他一共造了六段,每往下一段,就多用上一点统计规律。
第一段,二十六个字母加一个空格,每个符号的出现机会都一样。他翻开一本随机数表,抽到几号就记下第几个符号,得到的就是 XFOML 那一串。
第二段,照着字母出现的频率表来抽,E 抽中的机会是 12%,W 只有 2%。这一段抽出来的字母虽然还是有些杂乱,却已经能够念出声了。
第三段要让每个字母根据前一个字母来挑,这就是马尔可夫的那条链了。查表也做得到,香农却用了一个更省事的办法——
随手翻开一本书,随便指一个字母记下来;再翻到另一页往下读,读到这个字母,就把紧跟在它后面的那个字母记下来;然后再换一页,去找刚刚记下的这一个。书里字母前后相随的习惯,就这样原样搬到了纸上。看前两个字母的那一段,以及以词为单位的那两段,也都是这么组合出来的。
在备忘录他接着说,这类随机过程在数学上叫离散马尔可夫过程,文献里研究得很多。脚注里只列了法国数学家弗雷歇 1938 年的一本书,没提马尔可夫数《奥涅金》的那篇论文(也许还是因为俄语的晦涩难懂)。他还写道,要把这样一个马尔可夫过程变成一台"语言生成器",只需要让它每换一次状态,就吐出一个字母。
可是这台生成器走不远。香农写道,要是能造出更进一步的近似,会很有意思,"但到了下一步,工作量就大得吓人了"。好在对破译来说,第六段,也就是开头引的最后那一段,已经够用了:密码分析多半只看两三个词之内的局部结构。
战争结束三年后,香农把备忘录里的不少内容和这些年在家里琢磨的东西合在一起,写成了另一篇论文。1948 年 7 月和 10 月,《贝尔系统技术期刊》分两期登出了香农的《通信的数学理论》。那几段假英语原样搬了过去,"语言生成器"改叫了"信源"。
论文一开头就把意思区分的很清楚,"通信的语义方面,与工程问题无关"。电话公司只管把消息原样送到,消息说的是什么,不归工程师管。
可正是在这篇不管意思的论文里,香农算出了一个关于写作的数。只考虑八个字母以内的牵连,英语的冗余大约是 50%。他的解释很直白,我们写英文的时候,写下的东西有一半是语言的结构定下的,只有一半是自己选的。
八个字母,还不到两个词,更远的牵连都还没算进去呢。频率表到三个字母就用完了,翻书又太费工夫,要接着再往下走,得去另找一个装着英语统计的地方。
装在脑子里的统计
1950 年 3 月,香农去纽约参加第七次梅西会议。这是一群人讨论机器和大脑、通信和控制的小型会议,常客里有提出"控制论"的数学家维纳,也有人类学家米德。
香农在会上讲英语的冗余。讲完那几段假英语,他说,到这里就走不下去了,从来没人统计过词和词成对出现的频率,真要统计,这张表也大得没法用。
"不过,"他接着说,"我想到,我们每个说这门语言的人,心里都装着关于这门语言结构的大量统计知识,要是能把它取出来就好了。"
怎么取出来呢?让人猜。找一个没见过原文的人,从第一个字母猜起,猜中了往下走,没猜中就一直猜到中为止,旁边的人把他每个字母猜了几次都记下来。香农举的例子开头是 THERE IS NO REVERSE ON A MOTORCYCLE,摩托车是没有倒挡的。
开头的 T、H、E 都是一次就中,这不奇怪,英语里最常见的首字母是 T,T 后面最常跟 H,最常见的三个字母就是 THE。最难的是 REVERSE,R 猜了十五次,V 猜了十七次。MOTORCYCLE 猜到 C,后面的字母就一个也没错了。整段一百零二个符号,第一次就猜中的有七十九个。
听的人来了兴致,替受试者复盘起来。有人问 NO 的 N 怎么第二次就猜中了,有人说,"there is a""there is the""there is no"本来就是最常见的几种接法。香农说,他头两个大概猜的是 A 和 N,THE 放在这里听起来有点别扭。
香农想讲的核心意思是那一行数字。他说,这行数字和原文里的信息一样多。只要找来一个和受试者在数学上一模一样的双胞胎,让他照着数字去猜,数字是几就猜几次,原文就能一个字母一个字母地还原出来。
"数学上一模一样的双胞胎,我们当然没有"
"可数学上一模一样的计算机器,我们是有的。"
让一台机器在这头猜,发出去的只是它每个字母猜了几次,那头再放一台一模一样的机器,照着这些数字,就能把原文猜回来。猜得越准,发出去的数字里 1 就越多,消息也就能压得越短。
预测和压缩,在这里成了同一件事。
会议上有人问,这个办法能不能对付短语、从句、整句这么大的单位。香农的回答却出奇地保守。
他说,给出一百个字母,大概已经开始咬住短语了,可是,"我觉得,这种统计的办法到了某个地方就会失灵。语言里很长距离的结构能不能用一个统计过程来表示,我很怀疑;那些罕见到从来没有出现过的序列,谈论它们的概率还有没有意义,我也很怀疑"。
下一个发言的人把话题引到了作者的个人文风上,这句话就这么过去了。
预测与熵
半年后,香农把这些实验写成了论文。论文里只说"受试者",没写具体是谁。据作家格雷克后来的记述,这个人是香农的妻子贝蒂。
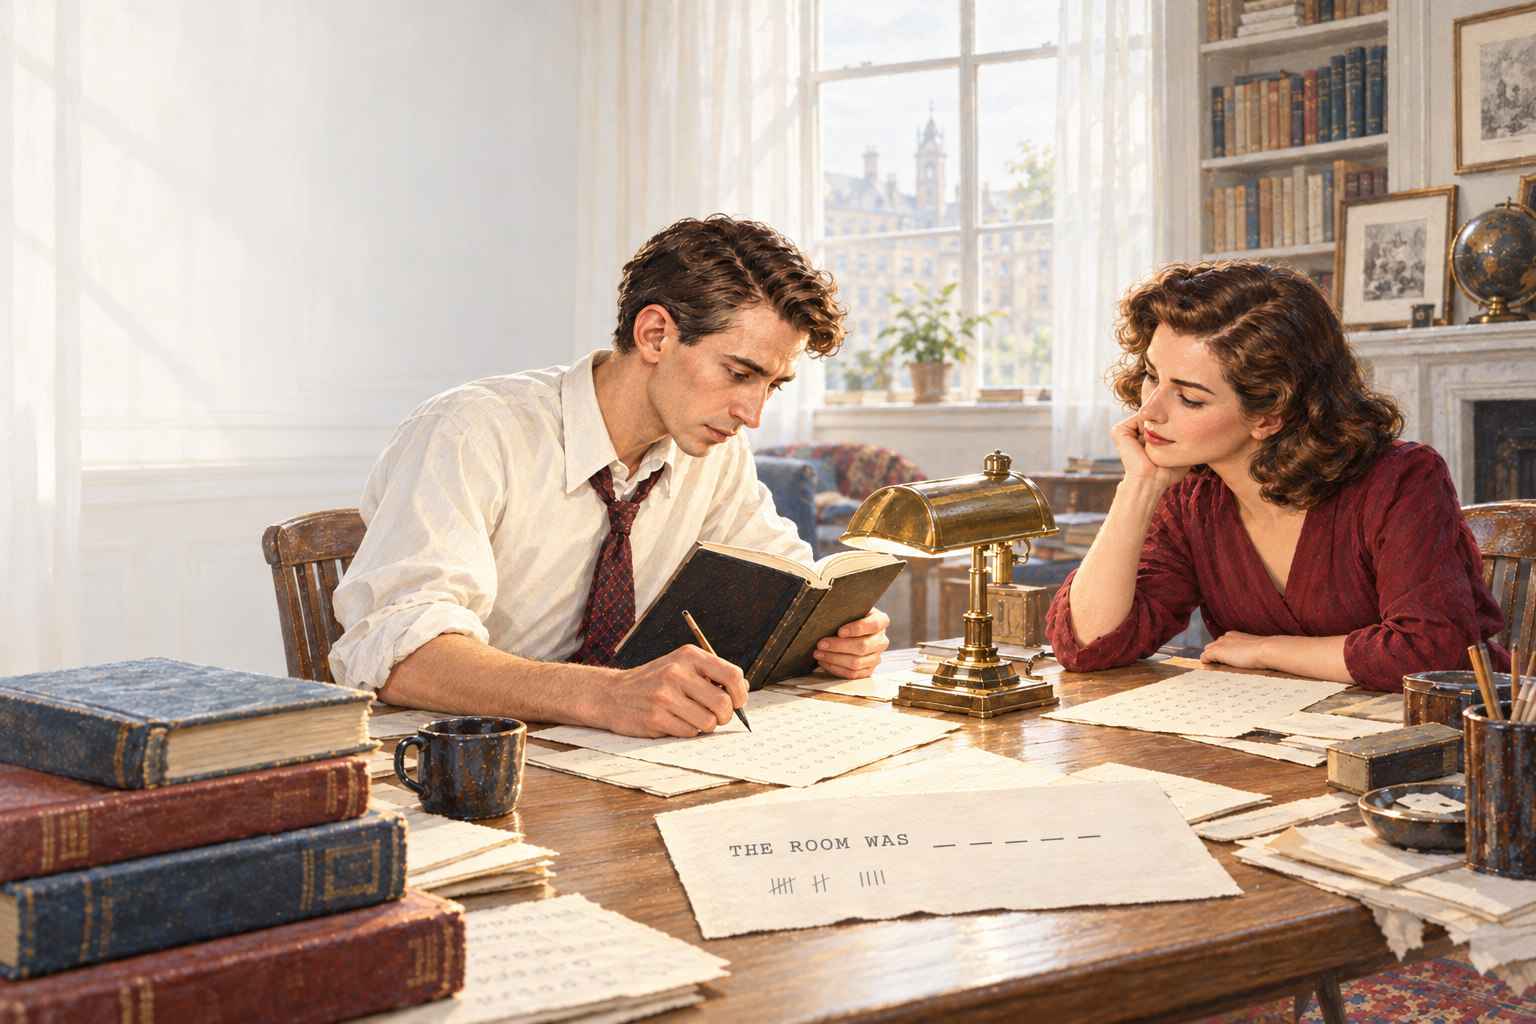
按格雷克的说法,香农从书架上抽出一本雷蒙德·钱德勒的侦探小说,随手指了一段,让贝蒂从第一个字母猜起,猜错了就告诉她正确的字母,接着猜下一个。
THE ROOM WAS NOT VERY LIGHT A SMALL OBLONG READING LAMP ON THE DESK SHED GLOW ON POLISHED WOOD BUT LESS ON THE SHABBY RED CARPET
屋里不太亮,书桌上一盏长方形的小台灯,光落在擦亮的木头上,照到那块旧红地毯上的就少了。
一百二十九个字母,她猜中了八十九个。
猜错的地方大多在一个词、一个音节的开头,香农分析到,那正是思路最容易岔开的地方。A SMALL OBLONG READING LAMP ON THE 之后,她把 D 猜错了,可一知道是 D,后面的 ESK 就一个没错。
要把猜字母变成一个能定量分析的过程,光这一段还不够。香农又从杜马·马隆写的杰斐逊传记里随机挑了一百段,每段十五个字母,让受试者一个字母一个字母地猜下去。这样一来,同一个人在只知道前面零个、一个、两个,直到十四个字母的时候,各猜了一百次。
另外一组,先给出一百个字母再猜。为了猜得准,受试者可以随便翻字母频率表、常用词表和一本字典。
只看前一个字母,就算照着频率表猜到最好,第一次猜中的也不到三成。可如果知道了前面一百个字母,一百次里有八十次是一次就猜中。
换算下来,算上一百个字母以内的牵连,英语每个字母只带一比特左右的信息,冗余大约是 75%。照香农 1948 年的说法就是——我们写下的英文,大约四分之三是语言替我们写好的。
1951 年 1 月,这篇《印刷英语的预测与熵》登在《贝尔系统技术期刊》上。论文最后一段是致谢,感谢玛丽·E·香农夫人和 B. M. 奥利弗博士在实验上的帮助。
此后几年,信息论走出了贝尔实验室,生物学、心理学、语言学、经济学,都在往自己的学科里搬"信息"和"熵"。
1956 年 3 月,香农在《IRE 信息论汇刊》上写了一篇只有一页的社论,题目叫《花车》,英语里跳上花车,说的就是赶时髦。他写道,信息论这几年成了科学界的一辆花车,可"信息、熵、冗余这几个激动人心的词,解决不了我们所有的问题"。
同一年 9 月,MIT 开了一场信息论研讨会,会上的论文后来登在同一份汇刊上。其中一篇出自一位二十七岁的语言学家,他在摘要里写道,没有哪一个状态有限的马尔可夫过程能充当英语的语法;照香农那样一阶一阶造出来的近似,阶数再往上提升,也不会离英语更近一步。
香农在梅西会议上一带而过的那点怀疑,到了这个年轻人手里,成了一个要严格证明的命题。
参考
- C. E. Shannon,A Mathematical Theory of Cryptography,贝尔实验室备忘录 MM 45-110-02,1945 年 9 月 1 日(机密),W. Diffie 2015 年整理本。三段假英语、"language generator"、"工作量大得吓人"、"元音删掉仍能还原"的冗余论证和破译只看两三个词的局部结构,都见第 3、4、31 节。
- Robert Price,Oral-History: Claude E. Shannon,IEEE History Center,1982 年 7 月 28 日。"让我看起来像在干正经事"、战时在家做研究、读《金甲虫》和小时候解密码题,见此。
- E. A. Poe,The Gold-Bug(1843)。勒格朗、羊皮纸上的符号、"8"出现三十三次、";48"对 THE,都出自这篇小说。
- C. E. Shannon,A Mathematical Theory of Communication,Bell System Technical Journal 27,1948。频率表出处(F. Pratt, Secret and Urgent, 1939;G. Dewey, Relative Frequency of English Speech Sounds, 1923)见脚注 5。
- G. Dewey,Relativ Frequency of English Speech Sounds,Harvard University Press,1923。十万个词的来源构成见第 8–9 页。
- C. E. Shannon,The Redundancy of English,第七次梅西会议发言及讨论,1950 年 3 月 23–24 日,收入 C. Pias 编 Cybernetics: The Macy Conferences 1946–1953,pp. 248–272。猜字母的演示、选书的对话、双胞胎和计算机器、"统计的办法到了某个地方就会失灵",都出自这份记录。
- C. E. Shannon,Prediction and Entropy of Printed English,Bell System Technical Journal 30,1951。
- J. Gleick,The Information(2011),第 229–230 页。受试者是贝蒂、那段文字出自钱德勒,都是这本书的说法,论文本身没有写。钱德勒原文核对见 archive.org 所藏的 Chandler 小说集。
- N. J. A. Sloane、A. D. Wyner,Biography of Claude Elwood Shannon。出生在佩托斯基、在盖洛德长大,见此文。
- Mary Elizabeth Moore "Betty" Shannon 讣告,2017;J. Soni、R. Goodman,Betty Shannon, Unsung Mathematical Genius,Scientific American 博客,2017。贝蒂的经历和两人相识,见此二文。
- H. Yu、L. R. Varshney,On "Composing Music by a Stochastic Process",IEEE Information Theory Society Newsletter,2017 年 12 月。贝蒂和皮尔斯 1949 年 11 月 15 日的作曲备忘录(MM-49-150-29)见此。
- C. E. Shannon,The Bandwagon,IRE Transactions on Information Theory IT-2(1),1956 年 3 月,第 3 页。
- N. Chomsky,Three Models for the Description of Language,IRE Transactions on Information Theory IT-2(3),1956 年 9 月。
评论
Discussion · 0登录后参与讨论 · Sign in to join the discussion
用 GitHub 账号登录,就可以评论、回复和表情回应。
使用 GitHub 登录还没有评论 · 来写下第一条吧。